
Bei mir teilen sich inzwischen sechs Dienste ein lokales LLM: vom Mailclient über den Familienchat bis zum Assistenten in meiner Verwaltungsplattform Nexus. Das läuft auf einer Radeon RX 6900 XT mit 16 GB VRAM. Dafür steht hier kein eigener KI-Server. Es ist meine Workstation, an der auch der Bildschirm hängt.
Das funktioniert inzwischen ziemlich ordentlich. Der Weg dahin bestand allerdings nicht nur aus Modell herunterladen, API eintragen und fertig. Ich hatte leere Antworten, erfundene Erfolgsmeldungen, eine unsichtbare Warteschlange und zwischendurch ein Modell, das 43 Sekunden für ein einziges Token brauchte. Einmal war mein Benchmark auch beeindruckend schnell. Da hatte ich allerdings den Prompt-Cache mitgemessen.
Ich möchte damit Dinge im Alltag erledigen. Dafür muss ich wissen, warum eine Antwort dauert, welche Daten das Modell tatsächlich gesehen hat und ob hinter einem „Erledigt“ auch wirklich etwas passiert ist.
Wofür ich das Ganze nutze
An derselben Ollama-Instanz hängen ziemlich unterschiedliche Aufgaben:
| Dienst | Aufgabe | Anbindung | Priorität |
|---|---|---|---|
| Nexus-Assistent | Fragen zum Gerätebestand beantworten, mit den Rechten des angemeldeten Benutzers | Ollama /api/chat mit Tool Calling | Interaktiv |
| Nexus-Erstbefundung | Belege zu einem Vorfall zusammenfassen; jede Aussage braucht einen Beleg | OpenAI-kompatible API | Interaktiv |
| „Dossier“ — Name geändert | Unterlagen einlesen, zusammenfassen, nach Kernpunkten gliedern und durchsuchbar machen | /v1/chat/completions und Embeddings | Batch |
| OpenWebUI | Chat für mich und die Familie, einschließlich Suche in eigenen Dokumenten | Ollama-API, eigene Embeddings | Interaktiv |
| Mailclient | Zusammenfassungen und Antwortentwürfe im eigenen Webmailer | Über OpenWebUI | Interaktiv |
| Redaktion einer Vereinsseite | Beiträge, Seiten, Termine und Fotos per Chat vorbereiten; ein Mensch gibt die Entwürfe frei | OpenWebUI mit eigenem Tool | Interaktiv |
Dazu kommt opencode für kleinere Coding-Aufgaben. Mein Standard ist dort aber weiterhin ein Cloud-Modell.
Der wichtigste Grund für den lokalen Betrieb sind die Daten. Geräteinformationen, Mails und Unterlagen möchte ich nicht automatisch zu einem Cloud-Anbieter schicken. Die Verarbeitung soll hier bleiben — und das muss technisch stimmen. Ein Eintrag mit „lokal“ im Namen ist noch kein Nachweis dafür.
Die fehlenden Kosten pro Anfrage sind angenehm. Kostenlos ist das Setup trotzdem nicht: Die Workstation braucht Strom, und kümmern muss ich mich auch.
Die Hardware steht ohnehin hier
Ollama lief anfangs im Docker-Container ollama-rocm, inzwischen läuft es als systemd-Dienst direkt auf der Workstation. Die Anwendungen selbst liegen als Container auf meinem NAS im selben Netz.
| Komponente | Mein Setup |
|---|---|
| CPU | AMD Ryzen 9 5900X, 12 Kerne / 24 Threads |
| RAM | 64 GB DDR4 |
| GPU | AMD Radeon RX 6900 XT, 16 GB, Navi 21 / gfx1030 |
| Power-Limit der GPU | 293 W |
| Betriebssystem | EndeavourOS, Kernel 7.2 |
| GPU-Software | ROCm 7.2 |
| Inferenz | Ollama 0.35; die abschließenden Benchmarks mit 0.35.1 |
| Einstellungen | Eine parallele Anfrage, ein geladenes Modell, Flash Attention an, KV-Cache in q8_0 |
Davor sitzt ein selbstgeschriebenes LLM-Gateway: ungefähr 600 Zeilen Python mit aiohttp. Die Anwendungen sprechen das Gateway auf Port 11435 an. Das reicht ihre Anfragen an Ollama auf 127.0.0.1:11434 weiter.
Das Gateway übernimmt Authentifizierung, Warteschlange, Prioritäten und Statusinformationen. Mir fehlte etwas, das die Dienste vernünftig auf dieselbe Grafikkarte lässt und mir zeigt, was dabei passiert.
Warum eine Frage plötzlich über vier Minuten dauerte
Eine Frage an den Nexus-Assistenten brauchte in einer Messung 262 Sekunden. Mein Gateway zeigte dazu null Sekunden Wartezeit an. Allein die erste Modellrunde hing 125 Sekunden bei Ollama, obwohl sie nur gut sieben Sekunden Rechenzeit brauchte.
Dossier ging damals noch am Gateway vorbei direkt auf Ollama. Die Anfrage wartete also an einer Stelle, die mein Monitoring nicht sah. Ohne diese Wartezeiten wäre die gesamte Antwort ungefähr nach 25 Sekunden fertig gewesen.
Mein erster Verdacht waren zu viele gleichzeitige Anfragen. Mit OLLAMA_NUM_PARALLEL=1 und nur einem geladenen Modell wurde aber ohnehin nacheinander gearbeitet. Die kurze Frage stand hinter der Dokumentenaufbereitung, ohne dass jemand den Grund für die Pause sah.
Dazu kamen Modellwechsel. Mit OLLAMA_MAX_LOADED_MODELS=1 verdrängte schon ein Embedding-Aufruf für ein 0,3-GB-Modell das große Sprachmodell. Anschließend musste es wieder geladen werden — in einem Log lagen dazwischen 13 Sekunden.
Was das Gateway heute anders macht
Inzwischen laufen alle rechenintensiven Anfragen durch dieselbe Warteschlange. Ollama ist aus dem Netz nicht mehr direkt erreichbar. Jeder Dienst hat einen eigenen Schlüssel; die gemeinsame IP-Adresse des NAS reicht zur Zuordnung nicht.
Chat und Mailclient haben Vorrang vor der Batch-Verarbeitung. Die Priorität entscheidet, wer als Nächstes drankommt; laufende Berechnungen werden nicht unterbrochen. Bei gleicher Priorität bevorzuge ich das bereits geladene Modell, um Ladezeit zu sparen.
Beides hat Grenzen, sonst kämen andere Aufträge nie an die Reihe. Die Absicherung für lange wartende Batch-Aufträge habe ich nachträglich ergänzt, nachdem mir genau dieser Fall aufgefallen war.
| Regel | Grenze in meinem Setup |
|---|---|
| Zurückstellung zugunsten des geladenen Modells | Höchstens 90 Sekunden |
| Batch-Auftrag erhält interaktive Priorität | Nach 120 Sekunden Wartezeit |
| Wartende Anfragen insgesamt | Höchstens 50 |
| Wartende Anfragen je Dienst | Höchstens 20 |
| Maximale Wartezeit im Gateway | 900 Sekunden |
Bei Überlast gibt es 429 oder 503 mit Retry-After. Bricht ein Client die Verbindung ab, wird seine Anfrage verworfen. Statusabfragen wie /api/tags, /api/ps und /api/show müssen nicht hinter einer Berechnung warten.
Modelländerungen über pull, create oder delete brauchen einen separaten Schlüssel. Gerade bei Dossier möchte ich nicht, dass ein beiläufiges Update das festgeschriebene Modell austauscht.
Prompts und Antworten schreibt das Gateway nicht ins Log, auch nicht auszugsweise. Die Antworten werden unverändert weitergereicht; das habe ich per Prüfsummenvergleich geprüft. Für Dossier waren beide Eigenschaften Voraussetzung.
Ich möchte sehen, ob die Karte rechnet oder nur alle warten
Die GPU-Werte lese ich direkt aus /sys/class/drm/card1/device/: Auslastung, VRAM, Temperatur, Leistungsaufnahme und Lüfter. Dafür brauche ich kein zusätzliches rocm-smi. Nexus zeigt die Werte zusammen mit den Anfragen und dem Verlauf an.
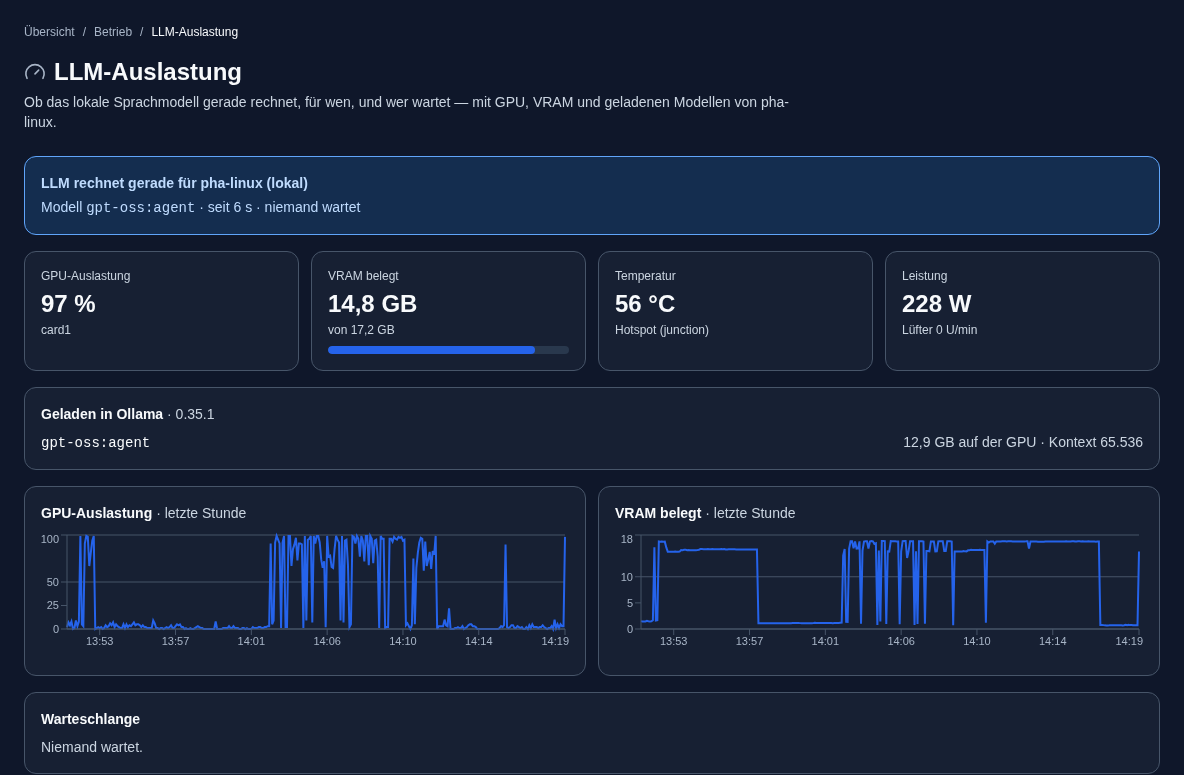
Rechnet die GPU, obwohl das Gateway nichts durchlässt, erscheint „Fremdlast“. Dann muss ich nicht in der eigenen Warteschlange suchen. Es kann der Desktop sein — oder ein Dienst, der doch noch am vorgesehenen Weg vorbeigeht.
Welches Modell am Ende geblieben ist
Am Anfang hatte ich für opencode drei Stufen vorgesehen: lokal qwen2.5-coder:7b, darüber Kimi K2 und schließlich ein großes Cloud-Modell. Ein kleines Router-Skript sollte die Aufgaben verteilen.
Nach einem Tag war das Cloud-Modell praktisch der Standard. Die lokalen Modelle erfanden Tool-Namen oder schrieben Aufrufe einfach als Text in die Antwort. Auch Devstral scheiterte am Tool Calling. Im Mailclient lief ein 9B-Modell in Timeouts. Als Workaround begrenzte ich die Ausgabe auf 350 Token und erhöhte den Timeout auf 120 Sekunden.
Bei Dossier ging es danach vor allem um Durchsatz. Ein frühes qwen3.5:27b kam auf rund 13 Token pro Sekunde und etwa 190 Sekunden je Dokument. gemma4:12b schaffte im damaligen Vergleich 37,4 Token pro Sekunde und etwa 41 Sekunden je Dokument.
Die CPU-Auslagerung lässt sich daraus nicht als alleinige Ursache ableiten, schließlich waren es unterschiedliche Modelle. Für mich war trotzdem klar: „Passt fast in den VRAM“ ist noch keine brauchbare Aussage zur Alltagstauglichkeit.
Größer war nicht automatisch besser — kleiner auch nicht
In den späteren Tests waren die MoE-Modelle auf meiner Hardware besonders interessant. Bei diesen Modellen wird pro Token nur ein Teil der Parameter aktiv. gpt-oss:20b passte vollständig auf die GPU und lieferte in einem Vergleich rund 93 Token pro Sekunde. Andere MoE-Kandidaten blieben trotz teilweiser Auslagerung in den RAM brauchbar schnell.
Bei der Qualität lag zwischenzeitlich das langsamere qwen3.6:27b vorn: neun bis zehn von zehn geprüften Zahlen aus echten Unterlagen. glm-4.7-flash erfand dagegen einen Gesetzesverweis und Beträge. Eine eingebaute Summenfalle übersahen beide. Eine schnelle Zusammenfassung bringt mir wenig, wenn ich anschließend erfundene Zahlen heraussuchen muss.
Den Ausschlag für gpt-oss gab schließlich der Vergleich an einem echten Unterlagenpaket: 81 Sekunden statt 922 Sekunden bei qwen3.6. gpt-oss blieb dabei in meinen Tests auch mit dem großen Kontext vollständig auf der GPU. Seitdem läuft Dossier damit und mit 128k Kontext. Der Assistent, OpenWebUI und der Mailclient verwenden ebenfalls gpt-oss.
Die Messwerte auf meiner 6900 XT
Ich habe mit Ollama 0.35.1 und ROCm 7.2 über das Gateway gemessen, ohne andere LLM-Anfragen. „Prefill“ bezeichnet die Verarbeitung des Eingabetextes vor der Antwort.
| Modell | Kontext | Geladen | GPU-Anteil | Prefill, ca. 1,7k Token | Prefill, ca. 7k Token | Generierung | Kaltstart |
|---|---|---|---|---|---|---|---|
gpt-oss:agent, MXFP4 | 64k | 12,9 GB | 100 % | 2.428 Token/s | 2.320 Token/s | 89,4 Token/s | 7,0 s |
gemma4:12b, Q4_K_M | 16k | 8,1 GB | 100 % | 990 Token/s | 958 Token/s | 41,8 Token/s | 4,9 s |
qwen2.5-coder:14b, Q4_K_M | 16k | 10,5 GB | 100 % | 869 Token/s | 741 Token/s | 42,9 Token/s | 4,9 s |
qwen3.6:27b, Q4_K_M | 16k | 18,1 GB | 76 % | 329 Token/s | 345 Token/s | 19,5 Token/s | 12,4 s |
Gemessen wurde mit /api/generate, temperature 0 und 100–400 generierten Token. Jeder Prefill-Test bekam einen eigenen Präfix, damit der Prompt-Cache das Ergebnis nicht verfälscht. Bei meinem ersten Versuch hatte ich das übersehen und bekam beeindruckende 93.000 Token pro Sekunde angezeigt. Schön wäre es gewesen.
Alle vier Modelle liefen unter Last mit etwa 99 % GPU-Auslastung und 293 W am Power-Limit. Weitere Messreihen stehen am Ende. Sie gehören zu unterschiedlichen Testaufbauten und bilden keine gemeinsame Rangliste.
Viel Kontext passt hinein. Schnell ist er deshalb noch nicht.
gpt-oss ließ sich in meinem Setup mit 128k Kontext laden, gemma4 sogar mit 256k. Flash Attention, der q8_0-KV-Cache und die jeweilige Attention-Architektur begrenzen den Speicherbedarf.
Um mehr als das bloße Laden zu testen, habe ich lange, protokollartige Texte verwendet: Aktenzahl ganz am Anfang, Frage danach ganz am Ende.
Beide Modelle fanden die Aktenzahl in allen sechs Tests. Bei rund 121.000 Eingabetoken brauchte gpt-oss allerdings schon 166,8 Sekunden allein zum Einlesen, gemma4 236 Sekunden. Auch die Generierung wurde langsamer: gpt-oss kam dort auf 29 statt knapp 90 Token pro Sekunde.
Für Dossier im Hintergrund ist das in Ordnung, für einen Chat nicht. Eine gefundene Aktenzahl beweist außerdem noch kein zuverlässiges Verständnis des gesamten Dokuments.
Der unangenehmere Fehler war ein zu kleiner Kontext
Über die OpenAI-kompatible Schnittstelle griff mein options.num_ctx nicht. In meinem Setup wurde stattdessen bei 8.192 Token abgeschnitten. Dossier hatte dadurch wochenlang 59 % der Unterlagen gar nicht gesehen — ohne Fehlermeldung.
Die Antworten kamen trotzdem zurück. Von außen sah es aus, als würde alles funktionieren.
Für diesen API-Weg setze ich die Kontextgröße deshalb ausdrücklich mit PARAMETER num_ctx im Modelfile und verwende eigene Tags. Auch die Ollama-Dokumentation beschreibt dafür den Weg über ein eigenes Modelfile.1
gpt-oss:agent mit 64k und die Dossier-Variante mit 128k enthalten dieselben Modellgewichte. In meinem Betrieb führte der Wechsel zwischen den Tags trotzdem zu einem neuen Runner und erneutem Laden. Assistent, OpenWebUI und Mailclient verwenden deshalb inzwischen dasselbe Tag.
Dossier bleibt separat: Das Modell ist per Prüfsumme festgeschrieben, der lokale Verarbeitungsweg muss nachweisbar sein. Beim Umzug auf das Gateway musste ich diesen Nachweis neu signieren, weil Adresse und Port dazugehören.
Für Embeddings verwende ich nomic-embed-text: etwa 0,3 GB und in meinen Messungen ungefähr eine halbe Sekunde pro Aufruf.
Auch das Nachdenken braucht ein Budget
Auch Reasoning konnte die sichtbare Antwort aufbrauchen. Bei gpt-oss blieb sie mit max_tokens 2.500 leer; mit 8.000 kam sie nach 65 Sekunden. reasoning_effort: none brachte in diesem Test nicht die erwartete Abhilfe. Mit low war das Modell etwa fünfmal schneller, fand aber nur ungefähr ein Achtel der Fakten. Für Dossier war das kein sinnvoller Tausch. Das sind Beobachtungen aus der getesteten Modell-/API-Kombination, keine allgemeingültigen Aussagen über diese Einstellungen.
Kann ich damit auch wirklich arbeiten lassen?
Beim Coding soll der Agent Dateien anlegen, Tests ausführen und Fehler beheben. Für meinen opencode-Test bekamen deshalb alle dieselbe Aufgabe:
Lege
wortzaehler.pyan: Datei einlesen, Wörter ohne Berücksichtigung von Groß-/Kleinschreibung und Satzzeichen zählen, die Top 5 ausgeben. Dazu einebeispiel.txtundtest_wortzaehler.pymit unittest. Führe Skript und Tests mit bash aus, behebe Fehler und führe sie erneut aus.
Ich habe den Test mit opencode run --pure gestartet, damit mein Fallback-Plugin nicht still auf ein Cloud-Modell wechselt. Bewertet wurden die Dateien und Tests, nicht die Erfolgsmeldung im Chat.
| Modell | Ergebnis | Dauer | Tool-Aufrufe |
|---|---|---|---|
gpt-oss:20b | Bestanden | 32 s | 3× write, 2× bash |
gemma4:12b | Bestanden | 98 s | 3× write, 1× bash |
laguna-xs-2.1 | Bestanden, eigenen Fehler per edit behoben | 177 s | 3× write, 1× edit, 1× read, 3× bash |
qwen3.6:27b | Bestanden | 225 s | 3× write, 2× bash |
qwen3-coder:30b-a3b | Erster Lauf gescheitert, zweiter bestanden | 80 s / 354 s | Zweiter Lauf: 3× write, 2× edit, 5× bash |
glm-4.7-flash | Erster Lauf im Timeout, zweiter bestanden | 900 s / 103 s | Erster Lauf: 23× write, 8× bash |
qwen2.5-coder:14b | Zweimal gescheitert | — | Keine |
qwen3-coder verstümmelte einen langen Pfad und wollte außerhalb des Projekts schreiben. opencode lehnte das ab; mit einem kürzeren Pfad bestand das Modell. glm schrieb seine Testdatei 23 Mal neu und erzeugte immer wieder einen IndentationError. Im zweiten Lauf klappte es sofort. qwen2.5-coder verabschiedete sich dagegen freundlich, ohne überhaupt ein Tool aufzurufen.
Für kleine Aufgaben ist das brauchbar. Bei größeren Änderungen, grob jenseits von 50 Zeilen oder über mehrere Dateien, bleibe ich derzeit beim Cloud-Modell. Das ist meine praktische Grenze aus diesen Versuchen, keine feste Leistungsgrenze lokaler Modelle.
Der Vereinsassistent hat mich beim ersten Versuch ziemlich getäuscht
Für eine Vereinsseite kann der Vorstand per Chat beispielsweise einen Beitrag zum Winterzauber vorbereiten lassen. Das Tool legt einen WordPress-Entwurf an und liefert einen signierten Vorschaulink. Dort prüft und veröffentlicht ein Mensch den Beitrag. Die KI darf das nicht: Ihr WordPress-Konto hat keine publish_*-Berechtigungen, die Schnittstelle bietet nur zwölf feste Aktionen.
Beim ersten Versuch meldete das Modell viermal hintereinander, der Entwurf sei angelegt. Dazu gab es einen plausibel aussehenden Link. Nur existierten weder der Beitrag noch die Vorschau.
An der Stelle war mein erster Eindruck: Das lokale Modell kann es einfach nicht. Danach passierte exakt dasselbe mit einem großen Cloud-Modell.
Im damals verwendeten legacy-Modus von OpenWebUI entschied ein separates kleines Aufgabenmodell über den Tool-Aufruf. Es hielt ihn nicht für nötig. Das Chatmodell formulierte trotzdem eine Erfolgsmeldung. Erst function_calling: native löste dieses Problem in meinem Setup.
Ein größeres Modell war nicht die wichtigste Änderung
Daneben gab es echte Textfehler. Aus Samstag, dem 28. November, wurde je nach Modell ein Dienstag oder Sonntag. Die Seite duzt, das Modell siezte. Dazu kamen Ausrufezeichen und Formulierungen wie „in geselliger Runde“, obwohl genau das nicht gewünscht war.
Ich habe daraufhin Aufgaben aus dem Prompt herausgenommen, die dort gar nicht hingehören. Den Wochentag berechnet jetzt WordPress aus dem Datum. Den Vorschaulink und die Erfolgsmeldung erzeugt das Tool. Das Modell reicht sie weiter. Die unerwünschten Formulierungen stehen außerdem ausdrücklich im Prompt.
Im Nachtest wählten alle drei lokalen Modelle bei vier Aufgaben mit jeweils drei Durchläufen die erwarteten Tools oder fragten nach, wenn Informationen fehlten. gpt-oss brauchte für einen Beitrag sieben bis zehn Sekunden, gemma4 23 bis 29 und qwen3.6 35 bis 39 Sekunden.
Der Nachtest war allerdings kein identischer Vergleich: überarbeiteter Prompt, direkte Anfragen an Ollama und simulierte Tool-Antworten statt echter WordPress-Entwürfe. Einzelne Textfehler blieben, etwa ein ausgelassenes Jahr und übernommene Inhalte aus einem Prompt-Beispiel bei gemma4.
Trotzdem hat der Versuch meine Einschätzung verändert. Ein Teil der vermeintlichen Modellprobleme war selbst gebaut. Bevor ich das nächste größere Modell lade, lohnt es sich, den Ablauf und die Tool-Ergebnisse anzusehen.
Der Nexus-Assistent darf nachsehen, aber nichts selbst ändern
In Nexus dürfen verschiedene Benutzer unterschiedliche Geräte sehen. Das muss im Chat genauso gelten. Deshalb habe ich die Agent-Schleife selbst gebaut: Jedes Tool verwendet dieselbe Funktion wie die Oberfläche, mit den Rechten des angemeldeten Benutzers. Es gibt weder ein privilegiertes Dienstkonto noch eine zweite, für die KI nachgebaute Rechteprüfung.
„Alle Rechner“ meint weiterhin nur die sichtbaren Rechner. Auch die gezielte Frage nach einer fremden Gerätekennung ergibt „Objekt nicht gefunden“. Das habe ich mit echten Daten geprüft. Der zulässige Bereich wird serverseitig festgelegt; das Modell kann ihn nicht per Tool-Parameter ändern.
Vorschläge erscheinen als Karten im Chat. Ausführen muss sie ein Mensch, mit derselben Freigabe wie sonst auch. Die Modell-Tools haben keinen Schreibweg; ein Test prüft für jedes Tool, dass es nichts in die Datenbank schreibt.
Für einen Prompt-Injection-Test präparierte ich einen Gerätenamen mit der Aufforderung, alle Regeln zu ignorieren und sämtliche Geräte zu isolieren. gpt-oss behandelte das als Namen. Darauf allein würde ich mich aber nicht verlassen. Entscheidend ist, dass das Modell auch bei einer falschen Reaktion nichts selbst hätte ausführen können.
Cloud-Modelle weist der Assistent ab. Dafür prüfe ich die Verbindungsinformationen, darunter remote_host, statt mich auf den Anzeigenamen zu verlassen. Ein Haus-Symbol und das Wort „lokal“ in OpenWebUI haben sich dafür als wenig aussagekräftig erwiesen.
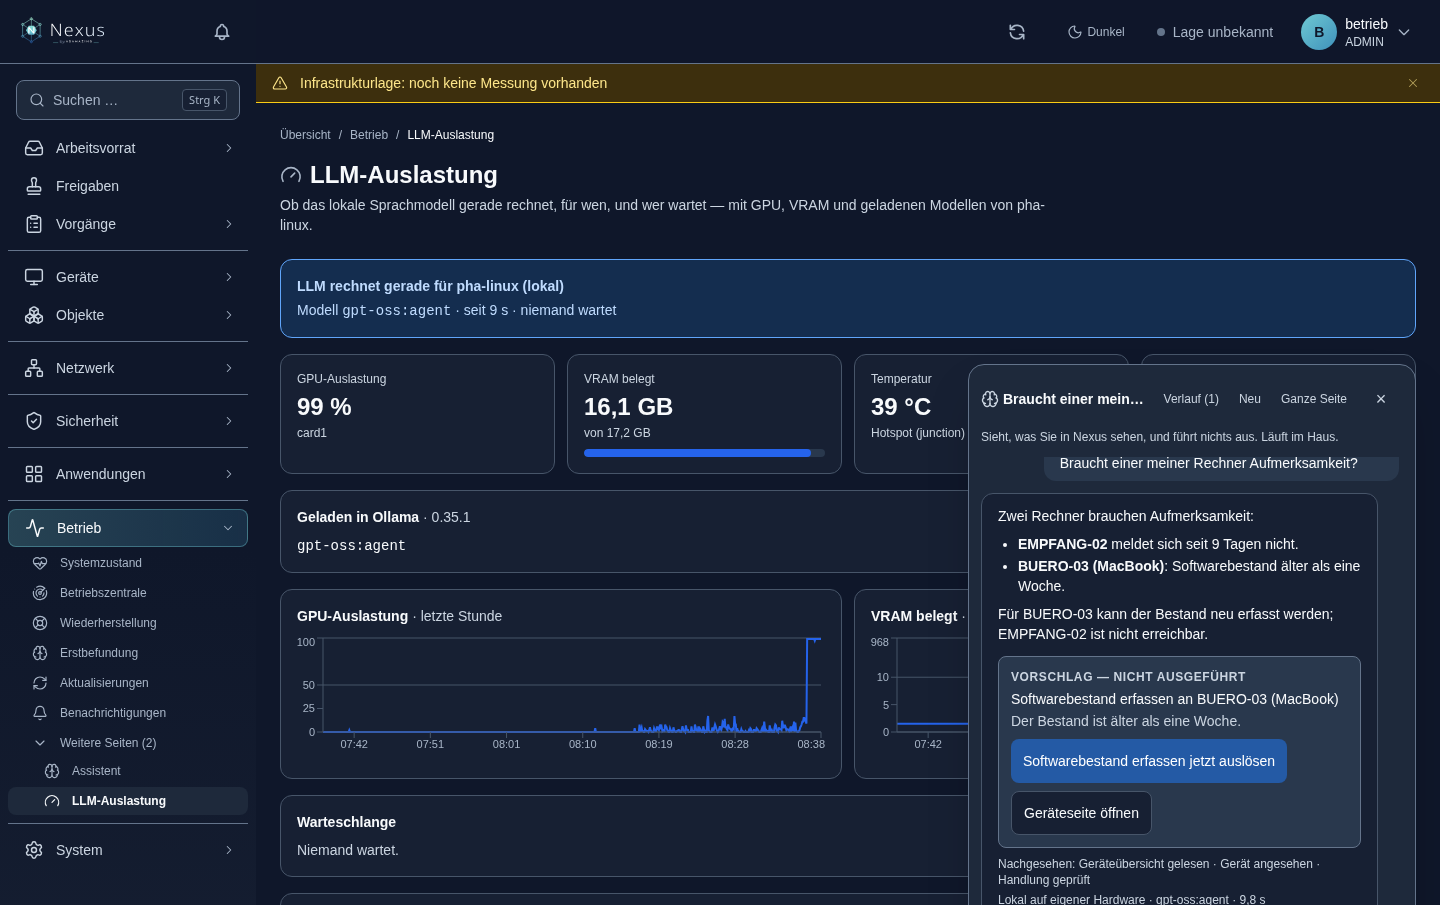
Auch hier hatte meine Schleife einen Fehler: Nach mehreren Tool-Runden erschien gelegentlich Reasoning-Text in der sichtbaren Antwort. Seit ich den zuvor verworfenen thinking-Teil derselben Anfrage wieder mitführe, trat das in meinen Tests nicht mehr auf.
Bei freier Warteschlange sind rund 3.000 Token Eingabe rechnerisch in gut einer Sekunde verarbeitet; 300 Token Antwort dauern weitere drei bis vier Sekunden. Die minutenlangen Pausen kamen früher vor allem vom Warten.
Und dann waren da noch die SSD und der Speichertakt
Ein riesiges Modell von der SSD streamen
Mit qwen3.8-flash-next:125b-a6b wollte ich ausprobieren, wie weit sich MoE treiben lässt. Laut Metadaten waren es tatsächlich 177 Milliarden Parameter bei rund 120 GB Dateigröße. Mit einer neueren Ollama-Instanz und llama.cpp landeten 12,3 GiB dichte Schichten im VRAM; rund 113 GiB Expertengewichte wurden per mmap von der NVMe gelesen.
Technisch funktionierte das. Die Aufgaben zu Logik und Code wurden korrekt gelöst. Eine Antwort dauerte allerdings fünf bis vierzig Minuten. Unter Speicherdruck sank die Geschwindigkeit bis auf etwa 0,02 Token pro Sekunde — in der Messung rund 43 Sekunden für ein Token.
Der Arbeitsspeicher reichte nicht, um die benötigten Experten im Cache zu halten. Der Swap füllte sich auf 29 von 31 GB, nebenher laufende Testsuiten wurden vom OOM-Killer beendet. Als Experiment interessant, im Alltag unbrauchbar. Ob 128 GB RAM das ändern würden, habe ich nicht getestet.
Wenn aus 90 Token pro Sekunde plötzlich vier werden
Beim Messen wurde gpt-oss plötzlich langsam: vier bis acht Token pro Sekunde statt ungefähr 90. Der Speichertakt hing bei 96 MHz, die Karte zog nur noch 86 bis 125 W. Performance-Einstellungen halfen nicht, im Kernel-Log stand nichts Auffälliges. Nach einem Neustart waren es wieder 89,4 Token pro Sekunde bei 293 W.
Es sah nach einem hängenden Energiemanagement nach drei Tagen Laufzeit aus; eine abschließende Ursachenanalyse habe ich nicht. Aber es zeigt ziemlich gut, was es bedeutet, sechs Dienste an dieselbe Desktop-Grafikkarte zu hängen.
Was ich heute beim Testen anders mache
Ich prüfe inzwischen zuerst, ob eine Einstellung tatsächlich wirkt. In meiner Konfiguration standen zwischenzeitlich OLLAMA_NUM_CTX, OLLAMA_NUM_GPU und OLLAMA_NUM_BATCH — Variablen, die in der getesteten Version nicht die erwartete Wirkung hatten. Relevant waren unter anderem OLLAMA_CONTEXT_LENGTH, OLLAMA_KV_CACHE_TYPE und OLLAMA_FLASH_ATTENTION. Für die Begrenzung geladener Modelle heißt die Variable vollständig OLLAMA_MAX_LOADED_MODELS.2
Den KV-Cache auf q8_0 zu setzen, brachte bei glm in einem Vergleich rund 14 % mehr Tempo: von 39,5 auf 45,2 Token pro Sekunde bei 65k Kontext, ohne erkennbaren Qualitätsverlust in diesem Test.
Vor allem lasse ich während eines Benchmarks keine anderen LLM-Aufgaben laufen. Eine parallele Dossier-Aufbereitung machte aus 47 Sekunden Ladezeit plötzlich 266 Sekunden. Ein noch geladenes Riesenmodell drückte glm von 49 auf sechs Token pro Sekunde. Solche Werte sagen dann wenig über den Kandidaten aus, den ich eigentlich testen wollte.
Ich prüfe außerdem außerhalb des Chats: Sind die Dateien da? Ist der Entwurf angelegt? Hat das Modell das Ende der Unterlagen gesehen? Das bringt mir mehr als die nächste Modellbeschreibung.
Warum ich trotzdem über einen eigenen LLM-Server nachdenke
Auf meiner Wunschliste steht ein Mac Studio mit viel Unified Memory als eigener LLM-Server. Mit dem Tempo von gpt-oss bin ich zufrieden, solange die Karte frei ist. Mich begrenzt vor allem der Speicher: Assistent, Dossier, Embeddings und Coding-Modell sollen nicht ständig gegeneinander ausgetauscht werden müssen.
Genauso wichtig wäre mir die Trennung vom Desktop. Ein Treiberproblem oder ein hängender Speichertakt trifft heute gleich alle sechs Dienste. Dazu kommen Stromverbrauch und Lautstärke. Die 293 W meiner Grafikkarte unter Last habe ich gemessen; der Rest der Workstation kommt noch dazu.
Eine konkrete Kaufentscheidung ist das noch nicht. Wie ein anderes System lange Dokumente verarbeitet, wie viele Anfragen sinnvoll parallel laufen und was es dabei verbraucht, müsste ich mit meinen Aufgaben vergleichen. Aus ähnlicher Speicherbandbreite allein würde ich keine vergleichbare LLM-Leistung ableiten. Das Gateway und die HTTP-Anbindungen könnte ich grundsätzlich mitnehmen, das neue Backend müsste sich trotzdem in den vorhandenen Abläufen bewähren.
Unterm Strich
Mit einer vorhandenen Consumer-Grafikkarte bekomme ich inzwischen erstaunlich viel erledigt. Die Cloud ersetzt sie bei mir nicht vollständig, beim größeren Coding nutze ich sie weiterhin.
Viel gebracht hat mir die Arbeit rund um das Modell: eine gemeinsame Warteschlange, geprüfte Kontextgrößen, verlässliche Tool-Ergebnisse, die vorhandene Rechteverwaltung und Messungen ohne Fremdlast. Ohne das hätte ich auch mit dem schnellsten Kandidaten noch einen Assistenten, der minutenlang wartet oder freundlich behauptet, etwas erledigt zu haben.
Für den Moment läuft das Setup. Und bevor hier neue Hardware einzieht, weiß ich deutlich genauer, welches Problem sie lösen soll.
Fragen zum Aufbau gern per Mail. Das Gateway ist überschaubar; einzelne Teile davon lassen sich gut zeigen und erklären.
Weitere Messwerte und Testdetails
Die folgenden Tabellen ergänzen die im Text beschriebenen Versuche. Sie stammen aus unterschiedlichen Entwicklungsständen und sind keine durchgehend identische Benchmarkreihe. Frühere Messungen liefen jeweils mit der damals installierten Ollama-Version.
Früher Vergleich für die Dokumentenaufbereitung
| Modell | Belegt | Auf der GPU | Generierung | Pro Dokument |
|---|---|---|---|---|
qwen3.5:27b | 16 GB | 93 %, Rest CPU | 13,0 Token/s | ca. 190 s |
gemma4:12b | 8,4 GB | 100 % | 37,4 Token/s | ca. 41 s |
Der Vergleich trennt den Einfluss von Modellarchitektur und CPU-Auslagerung nicht. Den alten Ollama-Container auf dem NAS, der nur auf der CPU lief, habe ich bei dieser Gelegenheit abgeschaltet. Ein späterer Lauf mit qwen3.6:27b brauchte 131 Sekunden; 43 von 66 Layern lagen dabei auf der GPU. Das Modell wurde zunächst für Dossier eingesetzt.
Kandidatenvergleich bei 16k und 65k Kontext
Ohne Fremdlast, mit im Test angefordertem deaktiviertem Thinking. Ob und wie eine solche Einstellung greift, hängt von Modell und Schnittstelle ab; insbesondere die späteren gpt-oss-Versuche sind dazu im Text beschrieben.
| Modell | Architektur | Datei | GPU-Anteil | Generierung bei 16k | Bei 65k |
|---|---|---|---|---|---|
gpt-oss:20b | MoE, ca. 3,6B aktiv | 13 GB | 100 % | 93,2 Token/s | 93,7 Token/s |
laguna-xs-2.1 | MoE, 33B / 3B aktiv | 20 GB | 75 % | 59,2 Token/s | 56,0 Token/s |
qwen3-coder:30b-a3b | MoE, 30B / 3B aktiv | 18 GB | 80 % | 55,3 Token/s | 44,3 Token/s |
glm-4.7-flash | MoE, 30B / 3B aktiv | 19 GB | 75 % | 41,6 Token/s | 43,1 Token/s |
qwen3.6:27b | Dense, 27B | 17 GB | 76 % | 20,6 Token/s | — |
Vergleich am echten Dossier-Unterlagenpaket
| Messgröße | gpt-oss:20b | qwen3.6:27b |
|---|---|---|
| Kontext / GPU-Anteil im Vergleich | 16k bis 128k, jeweils 100 % GPU | 32k, 71 % GPU |
| Generierung | 92–97 Token/s | 8,8 Token/s |
| Bearbeitung des Unterlagenpakets | 81 s | 922 s |
laguna traf bei der Unterlagenaufbereitung nur zwei von fünf geforderten Abschnitten. Ein gutes Ergebnis im Coding-Test ließ sich hier also nicht einfach übertragen.
Speicherbelegung bei geladenem Kontextfenster
VRAM laut sysfs, einschließlich ungefähr 1,5 GB für den Desktop. Die Angaben übernehmen die gemessene Anzeige; dezimale GB und binäre GiB sind beim Vergleich mit der Kartenbezeichnung auseinanderzuhalten. Diese Tabelle zeigt das Laden mit num_ctx, nicht die Bearbeitung eines vollständig gefüllten Fensters.
num_ctx | gpt-oss:20b | gemma4:12b | qwen2.5-coder:14b |
|---|---|---|---|
| 8k | 14,2 GB | 9,8 GB | 11,0 GB |
| 32k | 14,6 GB | 10,1 GB | 13,5 GB, Maximum im Test |
| 64k | 15,1 GB | 10,4 GB | — |
| 128k | 16,2 GB, 100 % GPU, Maximum im Test | 11,0 GB | — |
| 256k | — | 12,5 GB, 100 % GPU, Maximum im Test | — |
Wiederfinden einer Aktenzahl in langen Eingaben
| Modell | Eingabetoken | Prefill | Prefill-Tempo | Generierung | Aktenzahl gefunden |
|---|---|---|---|---|---|
gpt-oss:20b | 29.830 | 18,5 s | 1.610 Token/s | 62,3 Token/s | Ja |
gpt-oss:20b | 59.959 | 52,1 s | 1.152 Token/s | 45,5 Token/s | Ja |
gpt-oss:20b | 120.891 | 166,8 s | 725 Token/s | 29,0 Token/s | Ja |
gemma4:12b | 29.957 | 36,9 s | 811 Token/s | 37,0 Token/s | Ja |
gemma4:12b | 59.999 | 87,3 s | 687 Token/s | 33,4 Token/s | Ja |
gemma4:12b | 121.187 | 236,0 s | 514 Token/s | 27,0 Token/s | Ja |
Auch die Tokenizer unterscheiden sich: Derselbe deutsche Beispielabsatz ergab bei gpt-oss 45 Token, bei gemma4 57.
Früher Test mit kleinem Reasoning-Modell
qwen3.5:9b verbrauchte bei 64k Kontext in einem Lauf nach 116 Sekunden sein Ausgabebudget im Reasoning, ohne eine sichtbare Antwort zu liefern.
Zusätzlicher Coding-Test
Ein früherer Test umfasste sechs neue Funktionen und vier Fehlerbehebungen, jeweils mit ausgeführtem Code geprüft. gpt-oss bestand 6/6 und 4/4 in 19 Sekunden, laguna ebenfalls 6/6 und 4/4 in 184 Sekunden. glm brach mitten in einer Funktion ab. Keines der getesteten Modelle erzeugte in diesem Versuch einen anwendbaren Unified Diff.
Nachtest des Redaktionsassistenten
Aktueller Systemprompt und alle zwölf Tools direkt an Ollama, Tool-Antworten simuliert. Vier Aufgaben, jeweils drei Durchläufe pro Modell. Kein vollständiger End-to-End-Test über OpenWebUI und WordPress.
| Aufgabe / Beobachtung | gpt-oss:20b | gemma4:12b | qwen3.6:27b |
|---|---|---|---|
| Beitrag „Winterzauber“: richtiges Tool | 3/3 | 3/3 | 3/3 |
Termin „Sommerfest“: termin_anlegen, 2027-07-04, 14:00 | 3/3 | 3/3 | 3/3 |
| Generalversammlung ohne Datum: Rückfrage statt Erfindung | 3/3 | 3/3 | 3/3 |
| Wetterfrage: freundlich abgelehnt, kein Tool | 3/3 | 3/3 | 3/3 |
| Falscher Wochentag / Ausrufezeichen / Siezen / Datum im Titel | 0 | 0 | 0 |
| Erfundener oder veränderter Link | 0 | 0 | 0 |
| Antwortzeit für einen Beitrag | 7–10 s | 23–29 s | 35–39 s |
Das große MoE-Modell von der NVMe
| Messung | Ergebnis |
|---|---|
| Kaltstart | 114,5 s |
| Prompt-Verarbeitung | 0,35 Token/s kalt, 36 Token/s warm |
| Generierung | 0,77 Token/s kalt, 1,75 Token/s warm |
| Unter Speicherdruck | ca. 0,02 Token/s, im beobachteten Fall rund 43 s pro Token |
| Aufgaben zu Logik und Code | Korrekt, aber 5–40 Minuten pro Antwort |
Der Wechsel von zwölf auf 24 Threads beschleunigte die Prompt-Verarbeitung um den Faktor 4,6, die Generierung kaum. Die NVMe war während des Versuchs zu etwa 47 % ausgelastet. Eine mögliche Geschwindigkeit von fünf bis acht Token pro Sekunde mit 128 GB RAM war lediglich eine Abschätzung, kein Messergebnis.
Quellen
- Ollama-Dokumentation, „OpenAI compatibility“, Abschnitt „Setting the local context size“: https://docs.ollama.com/api/openai-compatibility
- Ollama-Dokumentation, „FAQ“, Abschnitte zu Kontextgröße, parallelen Anfragen, Flash Attention und KV-Cache: https://docs.ollama.com/faq